مهارت های خود را با بینش کارشناسان هفتگی از Growth Memo بهبود بخشید. به صورت رایگان سفارش دهید!
استراتژی پشت ویژگی جدید صفحات Perplexity شکاف عمیقی با ناشران ایجاد کرد، اما به نظر میرسد که واکنشها نامتناسب بوده است. خیلی جالب تر از مطالعه موردی محتوای هوش مصنوعی کاربر محور (UDC به جای UGC).
Perplexity Pages به کاربران این امکان را می دهد که “مقالاتی با طراحی زیبا و جامع در مورد هر موضوعی ایجاد کنند.” شما می توانید یک رشته، یک سری درخواست ها را به صفحه ای در مورد یک موضوع تبدیل کنید.
به عنوان یک خواننده دائمی یادداشت رشد، به سرعت متوجه خواهید شد که این یک استراتژی رشد است که در آن کاربران به طور ایدهآل محتوای هوش مصنوعی ایجاد میکنند که در جستجوی ارگانیک رتبهبندی میشود و بازدیدکنندگان را به perplexity.ai میآورد که به مشترکین پولی تبدیل میشوند.
استراتژی رشد با آنچه مدیر عامل شرکت سرینیواس به عنوان “جمع آوری دانش” توصیف می کند، مطابقت دارد. با ارائه یک تجربه کاربری برتر که به آن اجازه می دهد تقاضا را کانالیزه کند و عرضه را تولید کند، قدرت را حفظ می کند.
رها کردن در سطل
وقتی به داده های واقعی نگاه می کنیم، می بینیم که واکنش رسانه ها بسیار زیاد است. نه در نقد بلکه در تأثیرگذاری. منصفانه است که از Perplexity بخواهید تأثیر خود را ویرایش کند، از استانداردهای وب مانند robots.txt پیروی کند و از آدرس های IP رسمی مانند موتورهای جستجو استفاده کند.
به گفته توسعه دهنده Ryan Knight، Perplexity با مرورگر بدون هد که رشته IP آن را پنهان می کند، وب را می خزد.
مدیر عامل Srinivas گفت Perplexity با robots.txt مطابقت دارد و IP پوشانده شده از یک سرویس شخص ثالث آمده است. اما او همچنین اشاره کرد که “ظهور هوش مصنوعی مستلزم نوع جدیدی از رابطه کاری بین سازندگان محتوا یا ناشران و سایت هایی مانند او است.”
اما برای ابزار Perplexity، Pages یک قطره در سطل است.
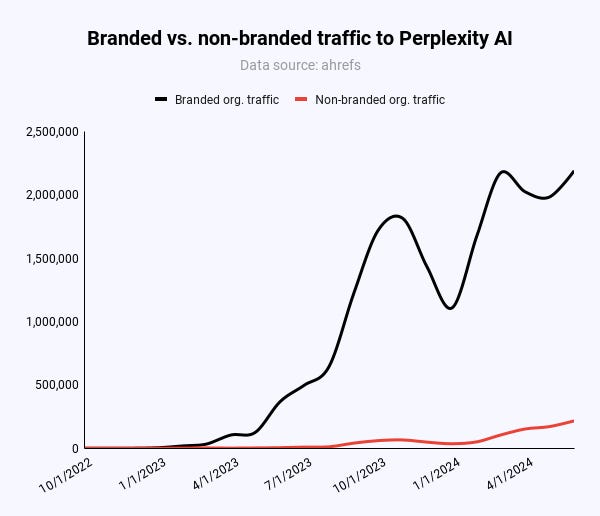
91 درصد از ترافیک ارگانیک perplexity.ai از کلمات کلیدی مانند “گیج” ناشی می شود.
تنها 47000 از 217000 (21.6%) بازدید کننده ماهانه صفحات از کلمات کلیدی ارگانیک و بدون مارک در سراسر جهان هستند.
در ایالات متحده 55٪ (20000/36000) است. با این حال، در مقایسه با x بازدید ماهانه برای اصطلاحات مارک، Pages در ترافیک ارگانیک Perplexity تاثیری ایجاد نمی کند.
 اعتبار عکس: کوین ایندیگ
در واقعیت، بیشتر ترافیک به Perplexity از برند و تبلیغات شفاهی آن میآید. پوشش رسانهای اخیر ممکن است بیش از آنکه صدمه بزند به Perplexity کمک کرده باشد. طبق گزارش Likeweb، این سایت از ژانویه 2024 هر روز به بالاترین میزان ترافیک خود رسیده است.
کل دامنه Perplexity فقط 950 صفحه دارد، با نزدیک به 600 صفحه در مقایسه با سایت های دیگر – مانند 6.8 میلیون مقاله ویکی پدیا فقط در نسخه انگلیسی – خیلی زیاد نیست. با افزایش جذابیت صفحات، جلوههای مقیاس قویتر ظاهر میشوند. در حال حاضر، Pages یک ویژگی جدید بتا است.
با نگاهی دقیق تر به اثربخشی آن، صفحات کلیدی با بیشترین جستجو با عبارت “کارامل مونتگومری مقصر بود” (600 MSV) در سه رتبه اول قرار می گیرند. سخت ترین کلمه کلیدی برای رتبه اول این است که “اولین خرید بیت کوین چه زمانی بود” (KD: 76، MSV: 30). به عبارت دیگر، Pages هنوز راه درازی در پیش دارد.
N=1 (!) مقایسه شباهت متن با GoTranscript بین صفحه بیت کوین پیتزا روز Perplexity و چهار منبع مرتبط آن شواهد کمی دال بر سرقت ادبی:
- Nationaltoday.com/bitcoin-pizza-day/ (15% شباهت).
- www.uledger.io/post/bitcoin-pizza-day-history (27% شباهت).
- coinedition.com/bitcoin-pizza-day-a-700-milion-reminder-of-cryptocurrency-rise/ (15%).
- www.investopedia.com/news/بیت کوین-پیتزا-روز-جشن-سفارش-20-میلیون-پیتزا/ (9%).
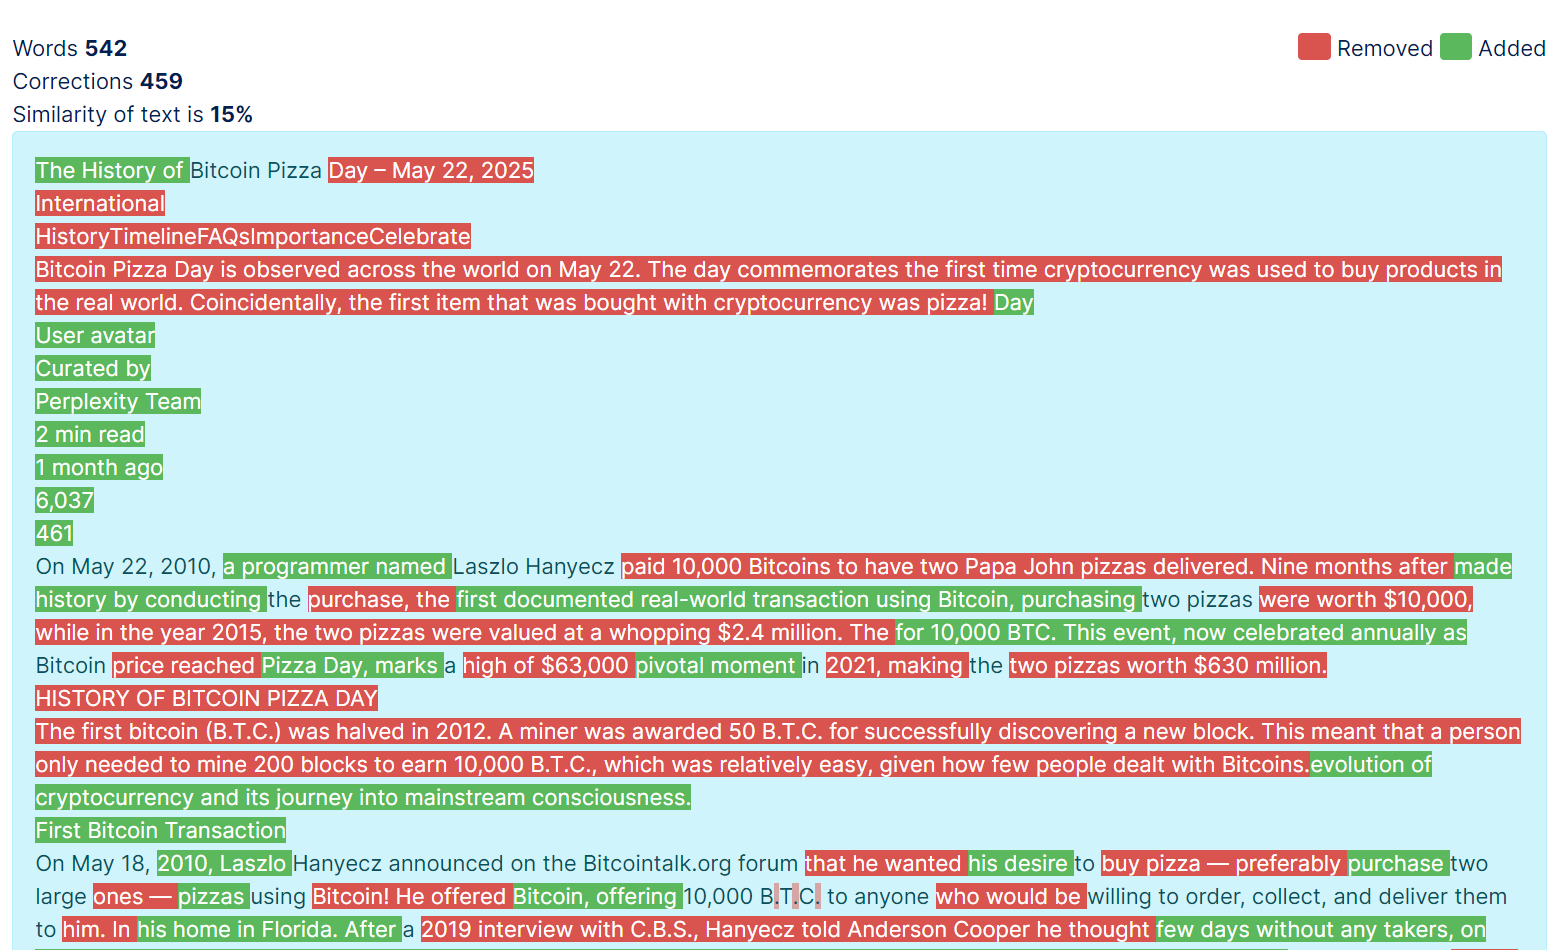 مقایسه متن بین Perplexity و مقاله NationalToday در مورد روز پیتزا بیت کوین (اعتبار تصویر: کوین ایندیگ)
همانطور که در مثال زیر نشان داده شده است، به نظر می رسد مشکل انتساب “فقدان” برطرف شده است.
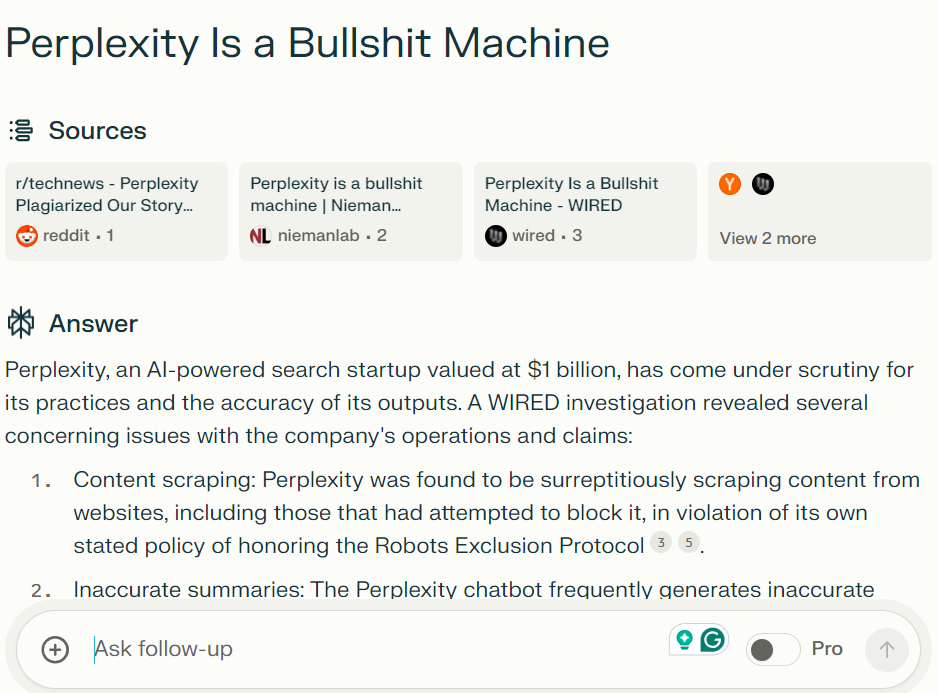 سردرگمی منابع پاسخ ها را در بالا برجسته می کند (اعتبار تصویر: کوین ایندیگ)
نتایج نشان داد که ربات چت گاهی داستانهای WIRED را با دقت بیان میکند و گاهی اوقات داستانها را به صورت نادرست و حداقل خلاصه میکند.
من نمیتوانم هیچ توهم را تأیید یا رد کنم، اما انتظار دارم مدلهای بهتر به نقطهای برسند که بتوانند محتوای موجود را بدون نقص خلاصه کنند. واقعیت این است که ما هنوز آنجا نیستیم. بررسی های هوش مصنوعی گوگل نیز نشان داده شده است که حاوی حقایق نادرست یا چیزهایی هستند.
به نظر می رسد گوگل توانسته است این مشکل را به سرعت حل کند، به همین دلیل است که انتظار دارم میزان توهم کاهش یابد.
یکی از مشکلات پشت انتقاد سرقت ادبی این است که جستجو برای عنوان دقیق یک مقاله، آن مقاله را برمی گرداند.
البته، Perplexity باید در صورت درخواست کاربران، خلاصه مقاله را برگرداند. Confusion چه چیز دیگری باید نشان دهد؟ همین ادعا در دعوای حقوقی بین OpenAI و نیویورک تایمز مطرح شد.
راه اندازی شد
علاوه بر مشکلات نمایه سازی که Perplexity باید آنها را برطرف کند، به نظر می رسد واکنش های رسانه ها باعث ایجاد موقعیت Perplexity می شود.
یک جمله در اعلان صفحات Perplexity در قلب مشکل اساسی قرار دارد:
با استفاده از Pages، برای ایجاد محتوای با کیفیت، نیازی نیست که یک نویسنده حرفه ای باشید.
در این صفحه همچنین اشاره شده است:
“ایجاد محتوای طنین انداز می تواند دشوار باشد. صفحات برای وضوح ساخته شدهاند، موضوعات پیچیده را به بخشهای قابل هضم تقسیم میکنند و به همه از معلمان گرفته تا مدیران خدمات ارائه میدهند.
همه نمونههای صفحات فهرستشده در آگهی درباره موضوعات «چگونه» یا «چیست» هستند:
- راهنمای مبتدیان درام نوازی
- “استفاده از AeroPress”
- “نوشتن Kubernetes CronJobs”
- “استیو جابز: مدیر عامل رویایی”
- و غیره.
این دقیقاً همان چالشی است که هوش مصنوعی برای نویسندگان ایجاد میکند: هوش مصنوعی میتواند فرمتهای محتوای واضحتر و واضحتری مانند راهنماها یا آموزشها را در بر بگیرد. من درک می کنم که این چگونه بر روزنامه نگاران تأثیر می گذارد.
محتوای کاربر محور
لطفاً توجه داشته باشید که Perplexity تمام محتوای صفحات را ایجاد نمی کند، بلکه آن را صادر می کند از مردم از طریق اعلان ها (UDC).
افراد به جای نوشتن یک مقاله کامل، تکه های پازل را کنار هم می گذارند و بیوگرافی نویسنده خود را روی صفحه می نویسند.
من انتظار دارم که همین اتفاق در مورد انواع دیگر محتوا مانند بررسی ها و پلتفرم هایی مانند Google، Tripadvisor، Yelp، G2 & Co رخ دهد تا ابزارهای مشابهی را برای تسهیل تولید محتوا ارائه دهند. بزرگترین چالش این است که کیفیت را بالا نگه دارید و اطلاعات غیر ضروری را به حداقل برسانید.
سوال بزرگ این است که آیا ساختاری مانند Pages می تواند با سایتی کاملاً انسانی مانند ویکی پدیا که در حال حاضر 116000 نویسنده فعال دارد رقابت کند.
بزرگتر “بازی رشد” (IMHO) در پشت صفحات این است که چگونه Perplexity پادکست های هوش مصنوعی (ویدئویی) را از مقالات هضم شده ایجاد می کند که فراتر از نتایج اصلی است.
“Perplexity سپس این داستان نهایی را از طریق یک اعلان فشار تلفن همراه برای مشترکین خود ارسال کرد. یک پادکست تولید شده توسط هوش مصنوعی با استفاده از گزارش های مشابه (فوربس) ایجاد کرد – بدون اعتبار از فوربس، و تبدیل به یک ویدیوی YouTube شد که از تمام محتوای فوربس در این زمینه برتری داشت. موضوع در جستجوی گوگل
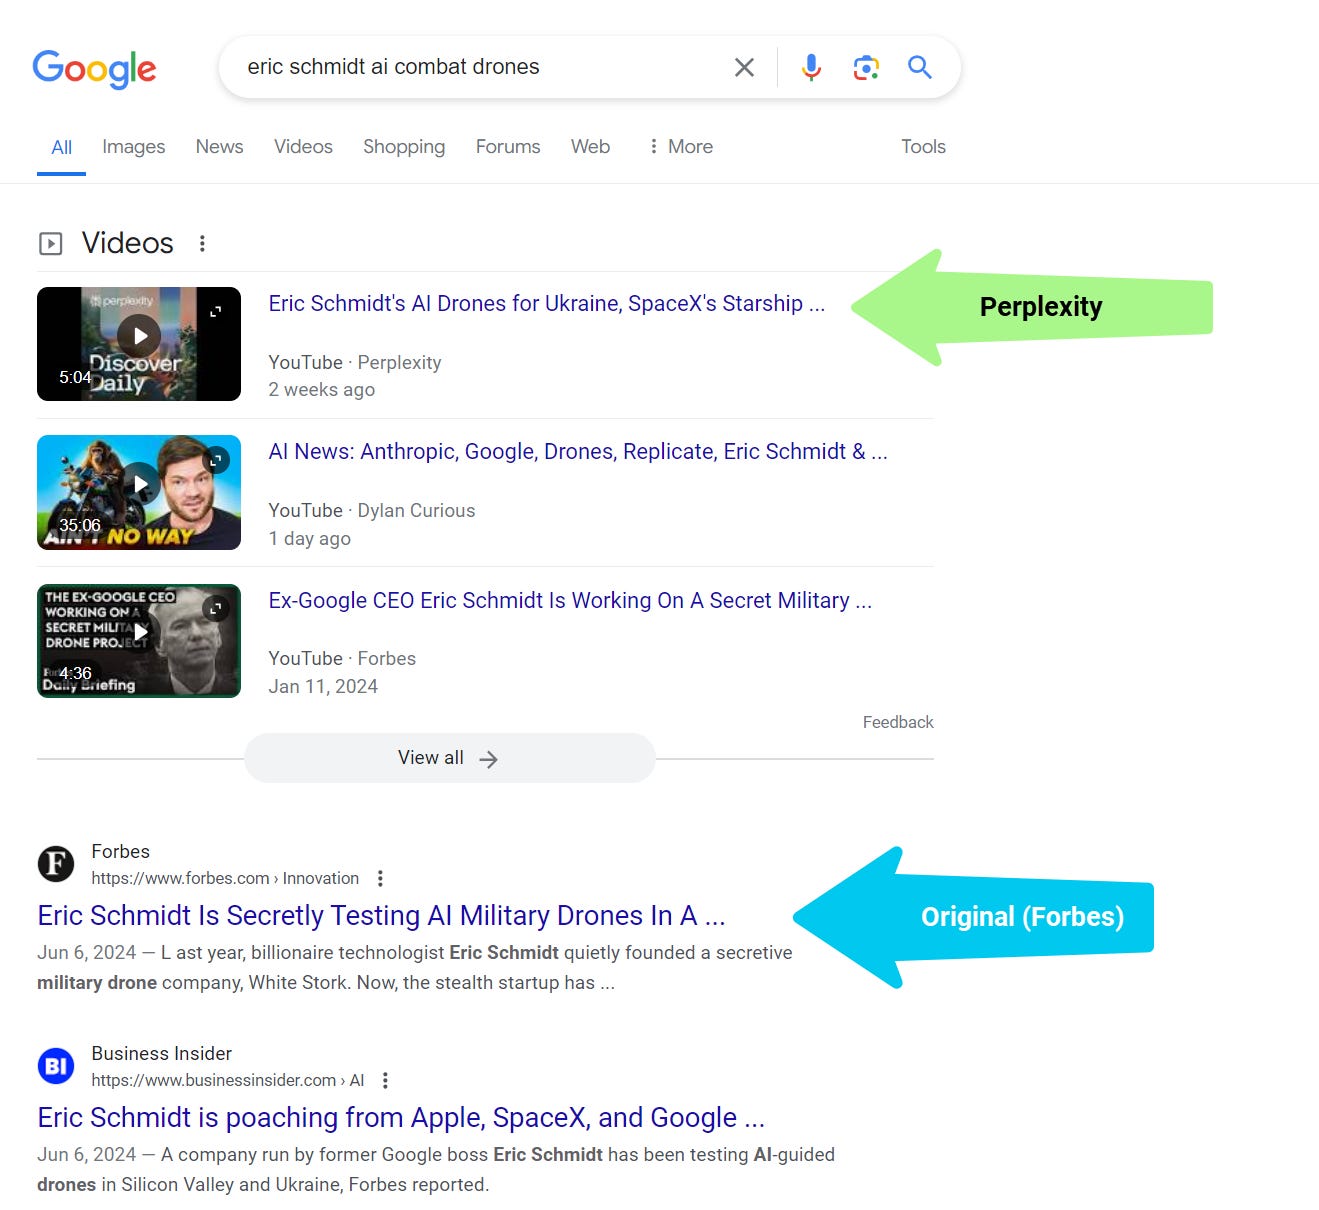 سردرگمی ناشران را با پادکستهای ویدئویی که خلاصهای از مقالات را در بر میگیرد، فرا میگیرد (اعتبار تصویر: کوین ایندیگ)
گوگل باید چگونگی جلوگیری از استفاده مجدد LLMها از محتوای ناشران را بیابد.
پس از بررسی حقایق، متوجه میشوید که برقراری تعادل در ارائه پاسخ هوش مصنوعی و همچنین ارسال ترافیک به منابع چقدر دشوار است. چرا وقتی کاربران به اکثر سوالاتشان پاسخ داده شده باید کلیک کنند؟
در روی دیگر سکه، ناشران خودشان می توانند خلاصه مقالات خود را ارسال کنند. بنابراین، چالش کلیدی برای Perplexity – و هر کسی که به دنبال ایجاد محتوای AI در مقیاس بزرگ برای جستجو است – اضافه کردن ارزش منحصر به فرد به خلاصههای AI است.
مسیر رسیدن به ارزش منحصر به فرد از خلاصه های هوش مصنوعی و سایر محتوای هوش مصنوعی است شخصی سازی.
سیستمی که درک ترجیحی شما از یک موضوع را تشخیص دهد، میتواند خلاصههای هوش مصنوعی را برای شما مفیدتر کند. سردرگمی شرکتهای مختلف LLM را احاطه کرده است، اما اگر دادههای قابل توجهی در مورد کاربران جمعآوری کند و نتیجه را شخصیسازی کند، میتواند ارزشی فراتر از پاسخهای سریع بیافزاید.
سازندگان سیستم عامل دستگاه مانند آلفابت و اپل بیشترین مزیت را در مورد داده های کاربر دارند زیرا در صدر زنجیره غذایی قرار دارند.
یک مثال قوی Apple Intelligence است که احتمالاً می تواند به سؤالاتی که در حال حاضر توسط راهنماها و آموزش های Google یا Perplexity ارائه شده است پاسخ دهد.
Apple Intelligence (که به اختصار “AI” نامیده می شود – خوب، اپل!) دارای زمینه کامل از طریق مکان (Apple Maps)، استفاده از برنامه شخص ثالث، درخواست های Siri، ایمیل (Apple Mail) و سایر منابع است و پایه خوبی برای سفارشی سازی ایجاد می کند. نتایج در. وب تنها مجموعه دیگری از داده ها است و در Dropbox، صندوق ورودی جیمیل و عکس های آیفون ما بسیار جذاب تر است.
امروزه، پاسخ های شخصی چشم انداز و ارائه است.
اما در مقطعی در آینده، شخصیسازی پاسخهای بهتری نسبت به هر خلاصه عمومی LLM و مطمئناً بیشتر از هر راهنمای نوشته شده توسط انسان ایجاد خواهد کرد.
ارزش اطلاعات تعریف شده و کلی در یک کورس تصادف با بمب افکن های LLM است. در عین حال، ارزش دانش شخصی، تجربه انسانی و تخصص قابل اعتماد در حال افزایش است.
استارتآپ هوش مصنوعی Perplexity میخواهد تجارت جستجو را از بین ببرد. فوربس می گوید که آنها را از بین می برد. ادغام کننده در مقابل رشد جمع کننده
هوش مصنوعی Perplexity در مورد عامل کاربر خود دروغ می گوید
واکنش آراویند سرینیواس، مدیرعامل Perplexity به اتهامات سرقت ادبی و تخلف
صفحات گیجی چیست؟
معرفی صفحات سرگیجه
ویکی پدیا: درباره
چرا دزدی بدبینانه Perplexity نشان دهنده همه چیزهایی است که ممکن است با هوش مصنوعی به خطا برود
تصویر ویژه: پائولو بوبیتا / مجله موتور جستجو


