در عصری که داده ها باعث تصمیم گیری می شوند، نیاز به استخراج متن دقیق و کارآمد از تصاویر، اسناد و یادداشت های دست نویس هرگز بیشتر از این نبوده است. OCR سنتی یا فناوری تشخیص کاراکتر نوری سنگ بنای دیجیتالی کردن متن چاپی بوده است. این رویکرد سنتی با اسکن یک تصویر یا سند و تجزیه و تحلیل الگوها برای شناسایی شخصیت ها کار می کرد. معمولاً از پردازش تصویر برای شناسایی لبهها، اشکال و ساختارها استفاده میکند و سپس این الگوها را با الگوهای کاراکترهای شناخته شده مطابقت میدهد تا متن بصری را به فرم دیجیتال تبدیل کند.
بزرگترین مانعی که توسعه دهندگان با آن روبرو هستند این است که کل فرآیند مبتنی بر قانون است، یا به عبارت ساده، زمینه را درک نمی کند، که آن را مستعد خطا می کند. تخفیفهای سنتی اغلب ارقامی بیفایده هستند که متوجه میشویم تمام تلاشهایمان تقریباً بیهوده بوده است. بنابراین، به طور خلاصه، محدودیتهای آن در زمینه، ساختار و اشکالزدایی مانع کارایی آن شده است.
یک چشم انداز در حال تغییر
اما با ظهور LLM ها و به ویژه آنهایی که می توانند عکس بگیرند، شاهد فرصت های جدیدی در این زمینه هستیم. در این مقاله، بررسی میکنیم که چگونه OCR مبتنی بر LLM صنعت را متحول میکند و درها را به روی برنامههایی باز میکند که زمانی دور از دسترس بودند.
چرا LLM-OCR برتر است؟
قبل از بررسی دفترچه یادداشتی که در آن یک فایل pdf را به gpt میفرستیم تا OCR مبتنی بر LLM را ترویج کنیم، اجازه دهید برخی از مزایای این روش و اینکه چرا آن را یک تغییردهنده بازی در حال تکامل میدانیم، ببینیم.
درک متنی: یکی از مزایای اصلی OCR مبتنی بر LLM نسبت به OCR سنتی، توانایی آن در درک متن و معنای متن است. رویکردهای OCR سنتی تنها بر تبدیل متن بصری به کاراکترهای دیجیتال بدون درک محتوای معنایی متن تمرکز میکنند، بنابراین متن استخراجشده ممکن است چیزی معنادار تولید کند. در مقابل، مدلهای زبان بزرگ (LLM) میتوانند متن را تفسیر کنند و به آنها اجازه استخراج معنا و حتی تصحیح خطاها بر اساس اطلاعات اطراف را میدهند. این عملکرد شبیه به ما انسان ها است، جایی که درک متن به شفاف سازی متن مبهم یا مبهم کمک می کند.
خود اصلاحی: سیستمهای OCR سنتی اغلب با کیفیت تصویر ضعیف، فونتهای غیرمعمول، متنهای کج یا پیچ خورده و نویز پسزمینه دست و پنجه نرم میکنند. این عوامل می توانند هنگام چاپ متن، به ویژه هنگامی که وضوح بصری به خطر بیفتد، خطا ایجاد کنند. با این حال، LLM ها می توانند از مهارت های درک زبان خود برای حدس زدن در مورد شخصیت ها یا کلماتی که ممکن است مبهم به نظر می رسند استفاده کنند. این می تواند برای مناطق حساس مانند اسناد حقوقی مفید باشد. به زبان ساده، آنها می توانند اشتباهات تایپی را تصحیح کنند و با تفسیر آنچه که در متن “معنا دارد” فونت های غیرمعمول را کارآمدتر مدیریت کنند.
طراحی بهبود یافته: فرآیندهای OCR سنتی معمولاً متن خام و بدون ساختار را چاپ میکنند و به کاربران اجازه میدهند ساختار، طرحبندی و قالببندی را به صورت دستی اضافه کنند. LLM ها می توانند طرح بندی اسناد را تشخیص دهند و حفظ کنند، سرفصل ها را تشخیص دهند و عناصر پیچیده ای مانند جداول و لیست ها را مدیریت کنند. برای مثال، فرض کنید در حال ارزیابی فرمی هستید که در آن آدرس یک مورد را وارد میکنید. این می تواند در نزدیکی کلمه “آدرس” قرار گیرد و می تواند بیش از یک خط داشته باشد. تشخیص متن سنتی نمی تواند این متن چند خطی یا تکه تکه شده فضایی را تفسیر کند، که LLM می تواند بر اساس درک زمینه ای آن را درک کند.
تشخیص دست خط و پردازش زبان: در حالی که OCR سنتی به دلیل تنوع در سبک ها و شکل شخصیت ها اغلب با دست خط دست و پنجه نرم می کند، LLM ها با استفاده از درک خود از الگوهای نوشتاری رایج این وظیفه را به طور موثرتری انجام می دهند. آنها با وجود کیفیت دستخط متفاوت، از زمینه برای رمزگشایی کلمات مبهم استفاده می کنند و خود را با سبک های مختلف نوشتاری تطبیق می دهند. این ویژگی OCR مبتنی بر LLM را به ابزاری قدرتمندتر برای دیجیتالی کردن اسناد یا یادداشتهای دستنویس تبدیل میکند. تشخیص متن سنتی همچنین به مدلهای جداگانه برای هر زبان نیاز دارد، که مدیریت اسناد چند زبانه را به چالش میکشد. با این حال، LLM ها می توانند چندین زبان را به طور همزمان مدیریت کنند، اسناد زبان ترکیبی را تفسیر کنند و حتی کارهای ترجمه را در طول OCR انجام دهند.
پس پردازش: سیستمهای OCR سنتی اغلب به چندین مرحله پس از پردازش برای پاک کردن متن، اصلاح مسائل قالببندی و استخراج مهمترین اطلاعات نیاز دارند. این باز هم مستلزم آن است که توسعه دهندگان به تکنیک های مختلف NLP پایبند باشند. از سوی دیگر، LLM ها با حذف خودکار تناقضات قالب بندی، تصحیح مسائل فاصله گذاری، و استاندارد کردن خروجی متن، این فرآیند را ساده می کنند. آنها همچنین می توانند مستقیماً اطلاعات مربوطه را استخراج کنند و نیاز به پس پردازش دستی اضافی را از بین ببرند.
پیاده سازی عملی
اکنون که همه اینها گفته شد، باید این ویژگی را با یک برنامه ساده بررسی کنیم. ما قصد داریم فایل pdf را دانلود کرده، آن را به عنوان تصاویر jpeg ذخیره کنیم و این تصاویر را به LLM ارسال کنیم تا پاسخ سوالات خود را دریافت کنیم. ما از Google Colab برای همه این فعالیت ها استفاده می کنیم.
برای شروع، ما یک فایل pdf چهار صفحه ای در مورد برنامه نویسی پایتون دانلود می کنیم. قبلاً می توانید از فایل pdf متوجه شوید که ساختار فضایی سند برای روش سنتی OCR غیرقابل درک است. شما می توانید دفترچه یادداشت colab را در اینجا پیدا کنید.
الف. ابتدا کتابخانه های لازم را وارد کنید
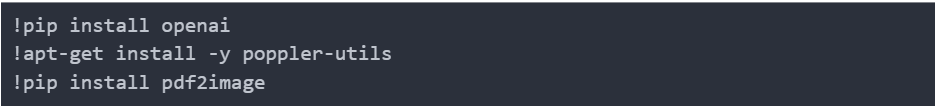
نصب کتابخانه Openai به شما امکان می دهد تماس های API را با Openai برقرار کنید، که از مدل های LLM استفاده می کنیم و GPT-4o همان چیزی است که در اینجا استفاده می کنیم. پوپلر-استفاده مجموعه ای از ابزارهای خط فرمان برای دستکاری فایل های PDF است. یکی از ابزارهای محبوب آن، pdftotext، فایل های PDF را به متن ساده تبدیل می کند که برای استخراج متن از فایل های PDF مفید است. صنوبر اغلب به کتابخانههایی بستگی دارد که فایلهای PDF را در پایتون مدیریت میکنند، مخصوصاً زمانی که صفحات PDF باید به تصاویر یا متن تبدیل شوند. Pdf2image یک کتابخانه پایتون است که برای تبدیل صفحات PDF به تصاویر استفاده می شود. مبتنی است صنوبر برای پردازش فایل های PDF
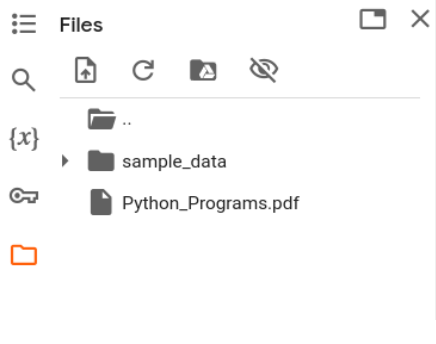
ب. اکنون فایل pdf Python_Programs را در پوشه محتوای Colab آپلود می کنیم
ج. تبدیل پی دی اف به تصویر
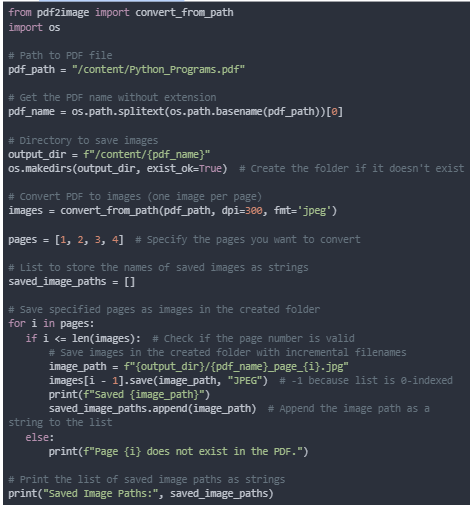
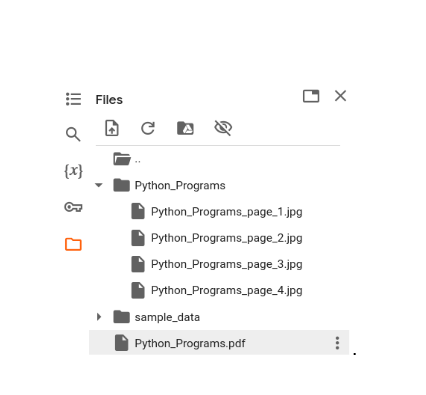
در اینجا ابتدا نام فایل PDF را استخراج می کنیم و یک پوشه در پوشه مشخص شده (/content/Python_Programs) ایجاد می کنیم. پس از تبدیل PDF به تصاویر (یکی در هر صفحه)، صفحات مشخص شده (مثلاً صفحات 1، 2، 3 و 4) را به عنوان فایل های jpg در پوشه جدید ایجاد شده ذخیره می کند. هر تصویر با نام فایلی ذخیره می شود که نام اصلی PDF و شماره صفحه را نشان می دهد (به عنوان مثال Python_Programs_page_1.jpg). این رویکرد خروجی ساختار یافته ای را ارائه می دهد که تصویر هر صفحه را در یک پوشه واحد با نام فایل های توصیفی سازماندهی می کند و شناسایی و جستجوی تصاویر هر صفحه را آسان تر می کند. بنابراین، نتایج ما در ساختار پوشه به این شکل خواهد بود.
د. پردازش تصاویر
این از طریق سه عملکرد به دست می آید.
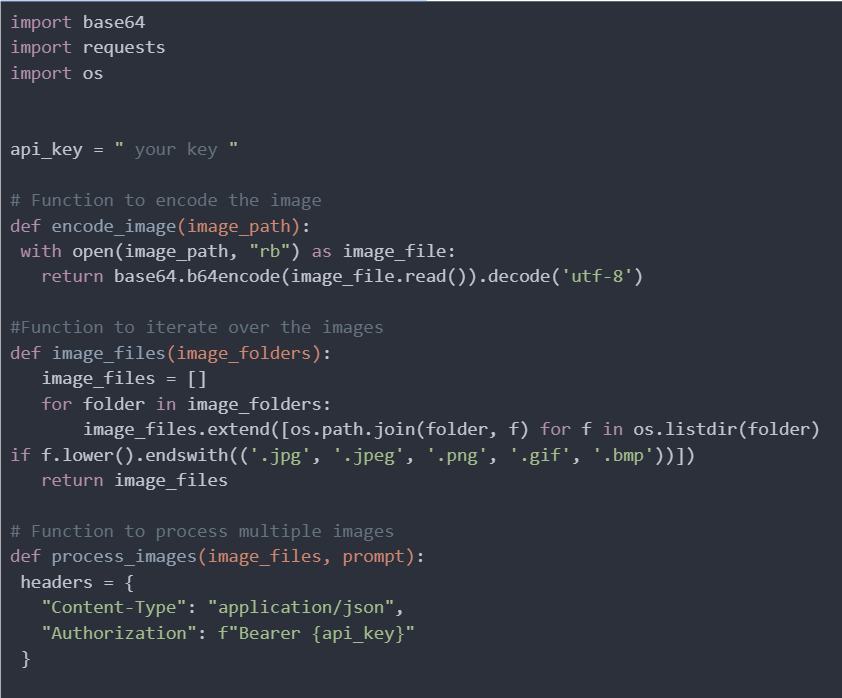
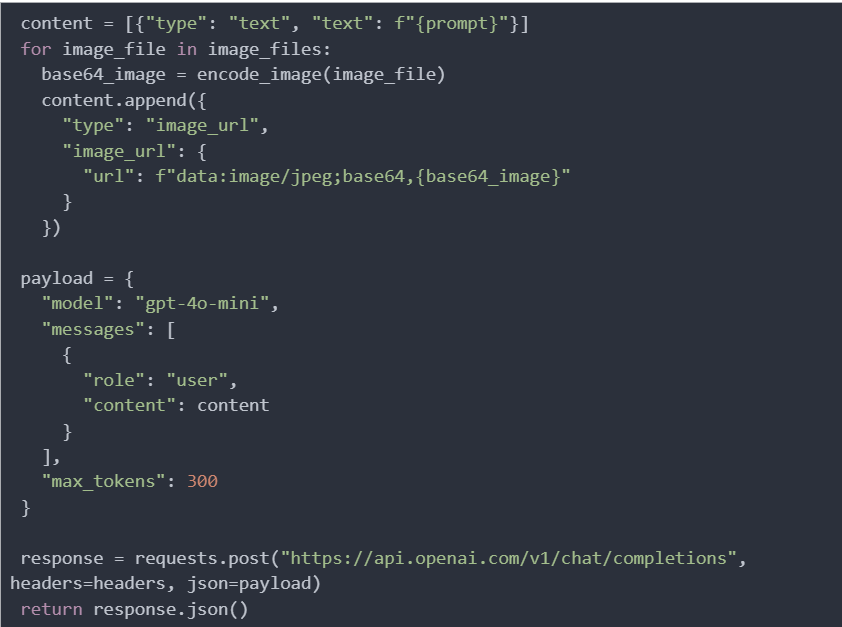
ابتدا، تابع encode_image یک فایل تصویری را در حالت باینری می خواند، آن را در base64 رمزگذاری می کند و رشته کدگذاری شده لازم برای جاسازی تصاویر را مستقیماً در درخواست های JSON برمی گرداند. سپس، تابع image_files لیستی از مسیرهای پوشه را می گیرد، در هر پوشه تکرار می شود و تمام مسیرهای فایل تصویر را با برچسب های خاص (jpg، .jpeg، .png، .gif، و bmp.) جمع آوری می کند، و یک لیست صاف از آنها را برمی گرداند. مسیرها
در نهایت، تابع process_images لیستی از مسیرهای فایل تصویر و یک درخواست متنی را میپذیرد، سرصفحههای درخواست را تنظیم میکند، محتوای پیام را با دستور مقداردهی اولیه میکند، هر تصویر را بهعنوان یک رشته کدگذاری شده با base64 اضافه میکند و یک فرهنگ لغت کاربردی میسازد که مدل را مشخص میکند. استفاده، نقش کاربر، و محتوای پیام مونتاژ شده برای ارسال به OpenAI API.
E. سپس این توابع را با نام صدا می زنیم
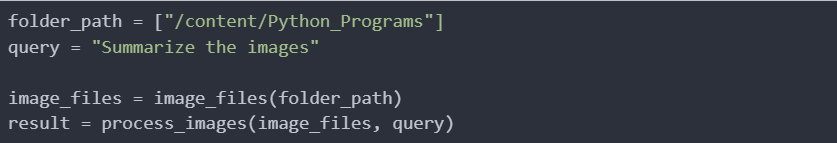
توجه داشته باشید که مسیر پوشه به صورت لیست ارسال می شود. بنابراین، در صورت لزوم، می توانید تصاویر را از بیش از یک پوشه به بار اضافه کنید.
F. نتیجه نهایی

و نتیجه نشان خواهد داد
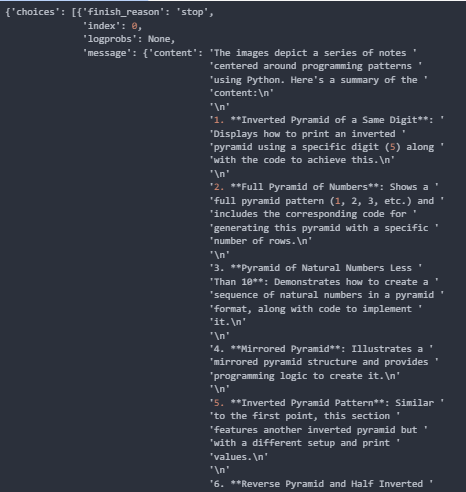
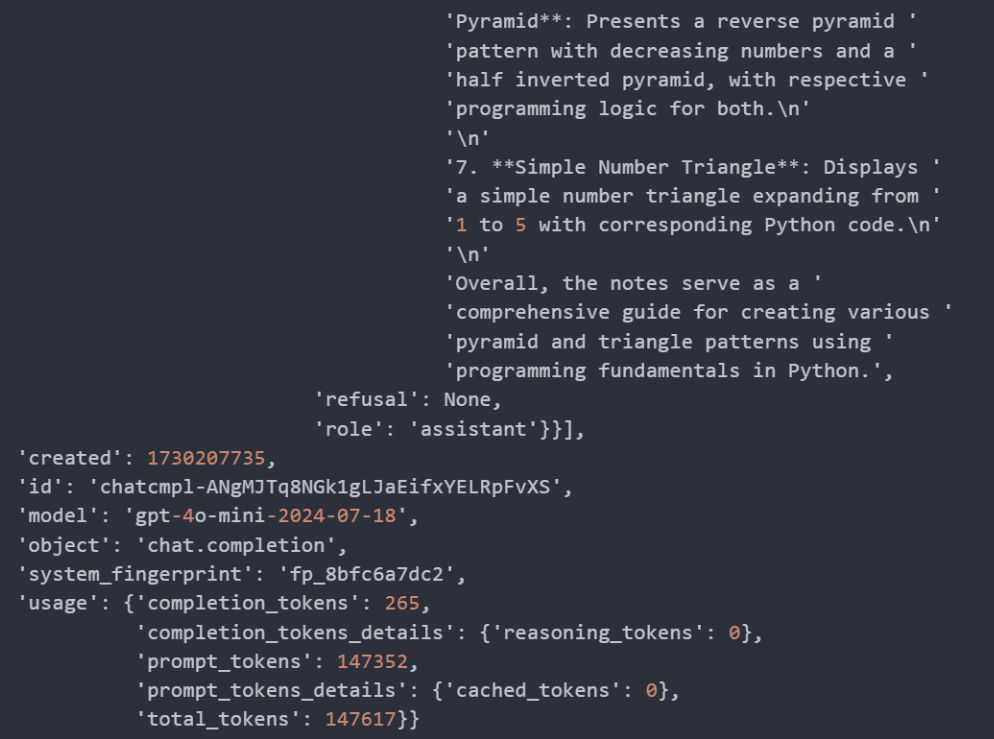
جلوتر
با OCR مبتنی بر LLM کلاه بردار. با خیال راحت کد را مطابق با نیاز خود تغییر دهید. اگر همچنان به تکنیک مشابهی علاقه دارید، https://github.com/getomni-ai/zerox مکان خوبی برای بازدید و مشاهده اطلاعات بیشتر است.